Les notes précédentes présentent le modèle de Solow en temps continu. Celle-ci le reprend en temps discret. Ce n'est pas une simple transposition : le passage d'une convention à l'autre soulève des questions de discrétisation, de calibrage et d'approximation qui n'ont pas d'équivalent dans le cadre continu, et qui sont exactement celles que l'on retrouve dans les modèles d'équilibre général dynamiques.
Du temps continu au temps discret
En temps continu, l'accumulation du capital par tête obéit à l'équation différentielle établie ici :
\[ \dot k(t) = sf\bigl(k(t)\bigr) - (n+\delta)k(t) \]
En temps discret, le stock de capital installé au début de la période \(t+1\) est ce qui subsiste du stock précédent, augmenté de l'investissement de la période :
\[ K_{t+1} = (1-\delta)K_t + I_t \]
Avec une population active croissant au taux \(n\), \(H_{t+1} = (1+n)H_t\), un taux d'épargne constant, \(I_t = sY_t\), et une technologie \(Y_t = A_tF(K_t,H_t)\) homogène de degré un, on obtient en divisant par \(H_{t+1}\) la loi d'évolution du capital par tête :
\[ (1+n)\,k_{t+1} = (1-\delta)k_t + sA_tf(k_t) \]
Trois remarques avant d'aller plus loin.
D'abord, le capital est prédéterminé. Le stock \(k_t\) résulte de décisions prises en \(t-1\) ; il ne réagit pas à ce qui se passe en \(t\). Cette convention de datation est sans conséquence dans le modèle déterministe, mais elle devient décisive dès qu'on introduit un aléa, et c'est une source d'erreur classique dans les simulations.
Ensuite, la loi d'évolution est explicite : le membre de droite ne dépend que de \(k_t\). Simuler le modèle non linéaire ne demande donc aucun solveur, une simple boucle suffit. Nous verrons à la section Du temps discret au temps continu que ce confort tient à la façon dont on a discrétisé, et non au modèle lui-même.
Enfin, pourquoi le temps discret. Les données sont datées trimestriellement ou annuellement, les simulations procèdent par pas, et les modèles d'équilibre général dynamiques sont généralement écrits en temps discret. Le modèle de Solow est le plus simple sur lequel on puisse voir à l'œuvre les difficultés propres à ce cadre.
Dans toute la note nous adoptons l'étalonnage suivant, celui de McCandless : \(\alpha = 0{,}36\), \(s = 0{,}20\), \(n = 0{,}02\) et \(\delta = 0{,}10\), la période étant l'année. Le progrès technique est nul sauf mention contraire.
État stationnaire et stabilité
L'état stationnaire \(\bar k\) vérifie \(\bar k = g(\bar k)\), soit :
\[ (1+n)\bar k = (1-\delta)\bar k + sAf(\bar k) \]
La condition d'état stationnaire du modèle en temps discret, \((n+\delta)\bar k = sAf(\bar k)\), est identique à celle du modèle en temps continu.
Il suffit de regrouper les termes en \(\bar k\) : le coefficient vaut \((1+n)-(1-\delta) = n+\delta\). Aucun terme croisé n'apparaît, parce que la croissance démographique entre multiplicativement d'un côté de l'égalité et la dépréciation additivement de l'autre. Nous verrons à la section Du temps discret au temps continu que cette coïncidence ne survit pas à l'introduction du progrès technique.
L'existence et l'unicité d'un état stationnaire non trivial reposent sur les mêmes arguments qu'en temps continu, la productivité moyenne \(f(k)/k\) étant monotone décroissante de l'infini vers zéro sous les conditions d'Inada. Nous renvoyons à la note sur le modèle de Solow pour la démonstration, qui ne dépend pas de la convention de datation.
La stabilité, en revanche, s'énonce différemment. En temps continu elle tient au signe de la dérivée ; en temps discret, au module de la pente de \(g\) au point fixe (qui doit être inférieur à 1 en module pour assurer la convergence locale).
La pente de la loi d'évolution à l'état stationnaire vaut :
\[ g'(\bar k) = \frac{(1-\delta)+(n+\delta)\alpha(\bar k)}{1+n} \]
où \(\alpha(k)\) désigne l'élasticité de la production par rapport au capital. Elle appartient à l'intervalle \(\left(\frac{1-\delta}{1+n},\,1\right)\) dès lors que \(\delta\leq 1\) : la convergence est monotone et l'état stationnaire localement stable.
En dérivant \(g\) on obtient \(g'(k) = \bigl[(1-\delta)+sAf'(k)\bigr]/(1+n)\). À l'état stationnaire, \(sAf(\bar k) = (n+\delta)\bar k\), donc
\[ sAf'(\bar k) = (n+\delta)\frac{\bar k f'(\bar k)}{f(\bar k)} = (n+\delta)\alpha(\bar k) \]
d'où l'expression annoncée. Comme \(0 < \alpha(\bar k)<1\), cette pente est comprise entre \(\frac{1-\delta}{1+n}\), obtenue pour \(\alpha=0\), et \(\frac{(1-\delta)+(n+\delta)}{1+n} = 1\), obtenue pour \(\alpha=1\). Elle est strictement positive tant que \(\delta\leq1\).
C'est un point qu'il vaut la peine de souligner, car on attend souvent du temps discret qu'il engendre des oscillations : le modèle de Solow en temps discret n'oscille jamais pour des valeurs admissibles de la dépréciation. La section Du temps discret au temps continu dira pourquoi, et à quelle condition il le pourrait.
Pour notre étalonnage, \(\bar k = 2{,}2215\) et \(g'(\bar k) = 0{,}9247\).
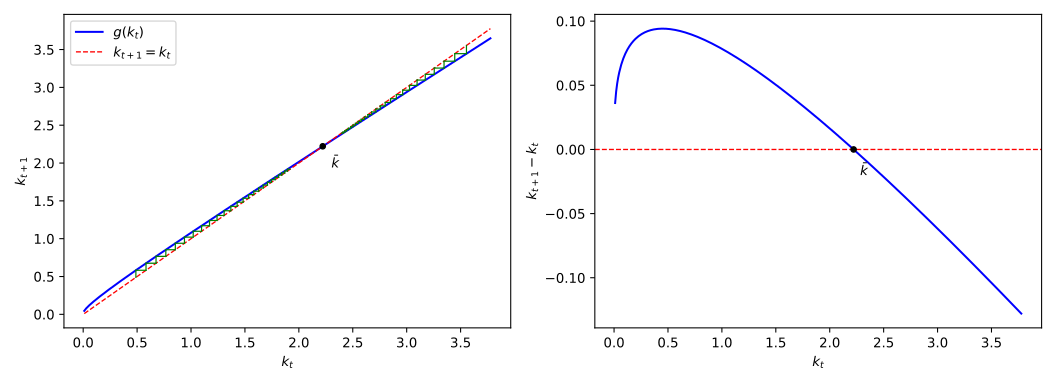
Figure 1 : Loi d'évolution du capital par tête. À gauche le diagramme à 45 degrés, à droite l'accumulation nette.
Vitesse de convergence
Approchons la loi d'évolution au voisinage de l'état stationnaire. En notant \(\tilde k_t = \log(k_t/\bar k)\) l'écart logarithmique, on obtient au premier ordre :
\[ \tilde k_{t+1} = B\,\tilde k_t, \qquad B = g'(\bar k) \]
Le capital suit donc un processus autorégressif d'ordre un, dont le coefficient est la pente calculée à la section précédente. On peut aussi lire cette dynamique comme une suite géométrique de raison \(B\). Cette écriture appelle une comparaison avec le temps continu, où la vitesse de convergence est \(\beta^{\star} = (1-\alpha)(n+\delta)\), comme établi ici.
En l'absence de progrès technique, le coefficient autorégressif du modèle en temps discret et la vitesse de convergence du modèle en temps continu sont liés par l'identité :
\[ 1-B = \frac{\beta^{\star}}{1+n} \]
D'après la propriété précédente,
\[ 1-B = \frac{(1+n)-(1-\delta)-(n+\delta)\alpha(\bar k)}{1+n} = \frac{(n+\delta)\bigl(1-\alpha(\bar k)\bigr)}{1+n} \]
et le numérateur est exactement \(\beta^{\star}\).
Le passage au temps discret divise la vitesse de convergence par le facteur démographique. Pour notre étalonnage, \(B = 0{,}9247\) et la demi-vie de l'écart à l'état stationnaire vaut \(\log 2/(-\log B) = 8{,}85\) années.
Cette identité vaut sous l'hypothèse d'absence de progrès technique. La section Du temps discret au temps continu montre ce qu'elle devient sans cette hypothèse.
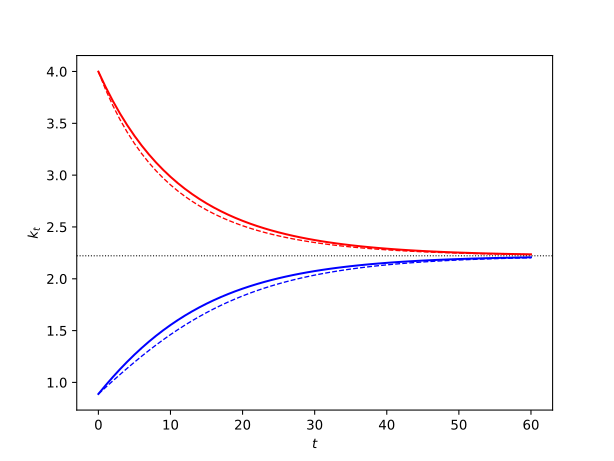
Figure 2 : Transitions exactes (trait plein) et approximation log-linéaire (tirets).
Croissance technologique et sentier de croissance équilibrée
Supposons maintenant que la technologie croisse à taux constant, \(A_t = (1+a)^tA_0\). Le capital par tête n'admet plus d'état stationnaire : il croît indéfiniment le long d'un sentier de croissance équilibrée, où le taux de croissance est constant.
Avec une fonction de production Cobb-Douglas, le capital par tête et la production par tête croissent le long du sentier équilibré au taux :
\[ \gamma = (1+a)^{\frac{1}{1-\alpha}}-1 \]
Cherchons un sentier le long duquel \(k_{t+1}/k_t\) est constant, égal à \(1+\gamma\). En divisant la loi d'évolution par \(k_t\) et en substituant \(f(k_t)=k_t^{\alpha}\), il vient :
\[ (1+n)(1+\gamma) = (1-\delta) + s(1+a)^tA_0k_t^{\alpha-1} \]
Le membre de gauche étant constant, \((1+a)^tk_t^{\alpha-1}\) doit l'être aussi, ce qui impose \(k_t\propto(1+a)^{\frac{t}{1-\alpha}}\) et donc \(1+\gamma = (1+a)^{\frac{1}{1-\alpha}}\). La production par tête, \(y_t=(1+a)^tA_0k_t^{\alpha}\), croît alors au taux \((1+a)\,(1+\gamma)^{\alpha} = (1+a)^{\frac{1}{1-\alpha}}\), identique.
L'exposant \(\frac{1}{1-\alpha}\) mérite un mot, car il n'apparaît pas dans nos notes en temps continu. Il tient à la façon dont la technologie a été introduite. Ici elle est neutre au sens de Hicks, elle multiplie la fonction de production ; dans la note sur la simulation du modèle de Solow elle augmente le travail, \(F(K_t,A_tH_t)\). Dans le cas Cobb-Douglas les deux conventions se réconcilient :
\[ A_tK_t^{\alpha}H_t^{1-\alpha} = K_t^{\alpha}\left(A_t^{\frac{1}{1-\alpha}}H_t\right)^{1-\alpha} \]
de sorte qu'un progrès technique neutre au taux \(a\) équivaut à un progrès augmentant le travail au taux \(x\) défini par \(1+x = (1+a)^{\frac{1}{1-\alpha}}\). Avec \(a = 0{,}02\) et \(\alpha = 0{,}36\), cela donne \(x = 3{,}14\,\%\). Confondre les deux conventions conduit à surestimer ou sous-estimer la croissance dans un rapport \(1/(1-\alpha)\), soit plus de moitié pour un étalonnage usuel.
Pour raisonner sur un état stationnaire il faut passer aux unités d'efficience, \(\hat k_t = K_t/(A_tH_t)\), ce qui donne :
\[ (1+n)(1+x)\,\hat k_{t+1} = (1-\delta)\hat k_t + sf(\hat k_t) \]
Du temps discret au temps continu
Prenons du recul et expliquons en quel sens le modèle en temps discret et le modèle en temps continu se répondent, où ils se séparent, et pourquoi il serait imprudent de tenir l'un pour la version approchée de l'autre.
Qu'est-ce qu'un schéma d'approximation ?
Une équation différentielle \(\dot x(t) = \varphi\bigl(x(t)\bigr)\), assortie d'une condition initiale, détermine une trajectoire unique — mais rarement une trajectoire que l'on sache écrire. Le modèle de Solow avec une fonction de production Cobb-Douglas fait partie des exceptions, et c'est ce qui nous permettra de mesurer les erreurs ; dès qu'on s'en écarte, il faut approcher la solution.
Un schéma d'approximation remplace la trajectoire continue par une suite de points \(x_0\), \(x_1\), \(x_2\), … censés valoir \(x(0)\), \(x(\Delta)\), \(x(2\Delta)\), … Le plus simple consiste à remplacer la dérivée par un taux d'accroissement :
\[ \dot x(t) \simeq \frac{x(t+\Delta)-x(t)}{\Delta} \]
Reste à décider où évaluer \(\varphi\), le membre de droite de l'équation différentielle. En début d'intervalle on obtient le schéma d'Euler explicite, en fin d'intervalle le schéma implicite :
\begin{cases} x_{t+\Delta} &= x_t + \Delta\varphi(x_t)\\ x_{t+\Delta} &= x_t + \Delta\varphi(x_{t+\Delta}) \end{cases}Le premier se calcule directement, le second demande de résoudre une équation non linéaire, pour \(x_{t+\Delta}\), à chaque pas — c'est toute la différence entre les schémas (S1) et (S2) de la sous-section Discrétiser, ou modéliser en temps discret ?.
Le schéma explicite suit la tangente à la trajectoire au point où il se trouve, et la suit pendant toute la durée \(\Delta\). Comme la trajectoire s'incurve, la tangente s'en écarte : à chaque pas, le schéma quitte la courbe intégrale qu'il suivait pour une autre. Le panneau de gauche de la figure ci-dessous montre ce mécanisme, avec en gris le faisceau des trajectoires exactes issues de chaque nœud.
L'ampleur de l'erreur se lit sur le développement de Taylor :
\[ x(t+\Delta) = x(t)+\Delta\dot x(t)+\frac{\Delta^2}{2}\ddot x(t)+o(\Delta^2) \]
Le schéma explicite n'en retient que les deux premiers termes. L'erreur commise en un pas est donc d'ordre \(\Delta^2\) ; sur un horizon fixe, qui demande \(T/\Delta\) pas, elle s'accumule en \(\Delta\). On dit que le schéma est d'ordre un : diviser la période par deux divise l'erreur par deux. Le panneau de droite le vérifie, la pente valant un en échelle logarithmique.
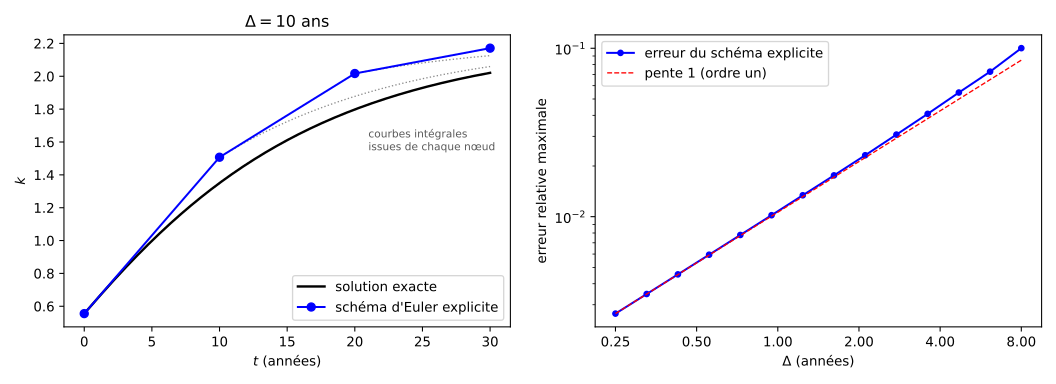
Figure 3 : Le schéma d'Euler explicite. À gauche il suit la tangente et quitte à chaque pas la courbe intégrale ; à droite son erreur est proportionnelle à la longueur de la période.
Le schéma implicite se lit de la même façon, à ceci près qu'il suit la tangente au point d'arrivée plutôt qu'au point de départ. La différence n'est pas anodine. Lorsque l'économie se rapproche de son état stationnaire, la pente diminue : le schéma explicite, qui retient la pente du départ, avance trop, et l'implicite, qui retient celle de l'arrivée, pas assez.
On observe alors que la solution exacte est encadrée par les deux schémas. Ce n'est pas un résultat général. Il faudrait pour cela que \(G\) soit monotone sur l'intervalle parcouru, c'est le cas ici, quel que soit le point de départ et quelle que soit la longueur de la période. Départ à \(0{,}25\,\hat k^{\star}\) avec \(\Delta=10\) ans :
| pas | explicite | exacte | implicite |
|---|---|---|---|
| 1 | \(1{,}3094\) | \(1{,}1369\) | \(1{,}0217\) |
| 2 | \(1{,}6801\) | \(1{,}4861\) | \(1{,}3554\) |
| 3 | \(1{,}7387\) | \(1{,}6381\) | \(1{,}5377\) |
Le panneau de droite de la figure ci-dessous isole un pas et montre d'où vient l'écart. Les deux schémas relient le même point de départ à deux points d'arrivée, par un segment dont la pente est, pour l'explicite, celle de la trajectoire au départ, et pour l'implicite, celle de la trajectoire à l'arrivée. Comme la pente décroît sur cet intervalle, le premier segment monte trop et le second pas assez.
C'est là que se paie l'implicite : sa pente dépend du point d'arrivée, qui est justement l'inconnue. Le capital de la période suivante n'est plus donné par une formule, c'est la valeur \(k'\) qui annule
\[ \Phi(k') = k'-k_t-\Delta\bigl[sf(k')-rk'\bigr] \]
La méthode de Newton la trouve en quelques itérations en partant de \(k_t\).
def newton(k, D, x=0.0, tol=1e-13, maxit=100):
    """Un pas du schéma implicite : résout k' = k + D[s f(k') - (n+x+delta) k']."""
    taux = n + x + delta
    y = k                                   # initialisation au point courant
    for _ in range(maxit):
        F = y - k - D*(s*f(y) - taux*y)
        Fprime = 1 - D*(s*fprime(y) - taux)
        pas = -F/Fprime
        y = y + pas
        if abs(pas) < tol:
            break
    return y
Six lignes, mais ce sont celles que met en œuvre tout solveur à anticipation parfaite, sur des systèmes de plusieurs centaines d'équations1.
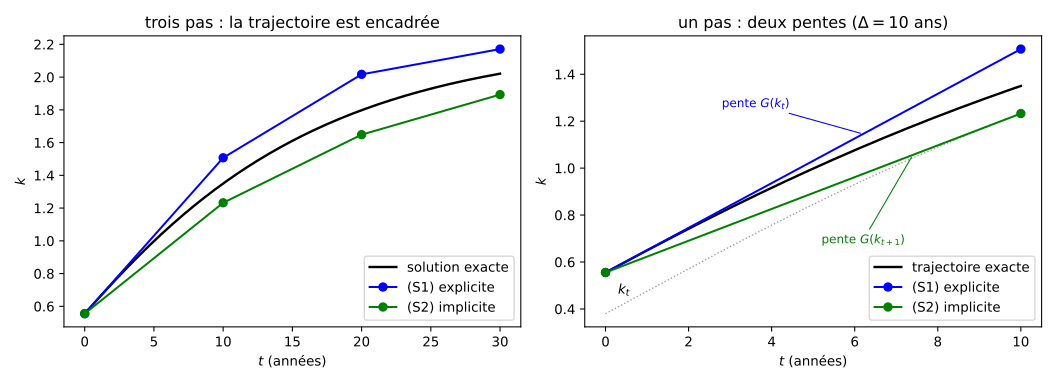
Figure 4 : Les deux schémas encadrent la trajectoire. À droite, un seul pas : chacun relie le départ à l'arrivée par un segment dont la pente est prise à l'une ou l'autre extrémité. En pointillés, la courbe intégrale passant par le point d'arrivée du schéma implicite.
La règle des stocks et des flux
Introduisons explicitement la longueur \(\Delta\) de la période. Sur un intervalle de cette durée, l'investissement et la dépréciation sont des flux : ils contribuent en \(sY\Delta\) et \(\delta K\Delta\). Le stock de capital, lui, ne se multiplie pas par \(\Delta\). D'où
\[ k_{t+\Delta} = k_t + \Delta\Bigl[sf(k_t)-(n+x+\delta)k_t\Bigr] \]
En divisant par \(\Delta\) et en faisant tendre \(\Delta\) vers zéro, on retrouve l'équation différentielle du temps continu. Le modèle qu'on obtient ainsi est le schéma d'Euler explicite de l'équation en temps continu — mais ce n'est qu'une des écritures discrètes possibles, et la sous-section Discrétiser, ou modéliser en temps discret ? montrera que la plus courante n'en est pas une. Manquer la distinction entre stocks et flux, c'est-à-dire oublier un \(\Delta\), conduit à un modèle dont les paramètres n'ont plus la dimension annoncée.
Pourquoi le modèle n'oscille pas, et quand il le pourrait
Pour ce schéma, la pente au point fixe prend une forme remarquablement simple.
Le schéma d'Euler explicite vérifie \(g'(\bar k) = 1-\Delta\beta^{\star}\). La convergence du modèle discrétisé est donc monotone si \(\Delta\beta^{\star}<1\), oscillante si \(1 < \Delta\beta^{\star}<2\), et divergente si \(\Delta\beta^{\star}>2\).
On a \(g'(k) = 1+\Delta\bigl[sf'(k)-(n+x+\delta)\bigr]\) et, à l'état stationnaire, \(sf'(\bar k) = (n+x+\delta)\alpha(\bar k)\). Il vient \(g'(\bar k) = 1-\Delta(1-\alpha)(n+x+\delta) = 1-\Delta\beta^{\star}\). Les trois régimes correspondent à \(g'>0\), \(-1 < g'<0\) et \(g'<-1\).
Tout s'éclaire. Avec \(\alpha = 0{,}36\), \(n = x = 0{,}02\) et \(\delta = 0{,}10\), la vitesse vaut \(\beta^{\star} = 0{,}0896\) : il faudrait une période de plus de \(1/\beta^{\star} = 11{,}2\) ans pour voir apparaître des oscillations, et de plus de \(2/\beta^{\star} = 22{,}3\) ans pour que le modèle diverge. À l'année, on est à \(\Delta\beta^{\star} = 0{,}09\), très loin du seuil. Le modèle de Solow en temps discret n'oscille pas, non parce qu'il ne le peut pas, mais parce que la période usuelle est courte devant l'échelle de temps de la convergence.
Discrétiser, ou modéliser en temps discret ?
Tout ce qui précède suppose que le modèle « vrai » est en temps continu et que les versions discrètes en sont des approximations. C'est un parti pris.
Deux points de départ sont également défendables. Ou bien l'on écrit le modèle en temps continu, et les écritures discrètes en sont des schémas numériques dont l'écart se mesure. Ou bien l'on écrit directement le modèle en temps discret, comme le font McCandless et l'essentiel la littérature d'équilibre général dynamique, et c'est alors l'équation différentielle qui apparaît comme une limite. Cette section adopte le premier point de vue, non parce qu'il serait le plus vrai, mais parce qu'il permet de chiffrer : la solution de l'équation différentielle est connue sous forme close dans le cas Cobb-Douglas, et fournit une référence.
Voici quatre écritures, qui ne sont pas de même nature.
(S1) Explicite : \(k' = k+\Delta\bigl[sf(k)-rk\bigr]\), où \(r = n+x+\delta\), résolu sous forme close.
(S2) Implicite : \(k' = k+\Delta\bigl[sf(k')-rk'\bigr]\), le membre de droite étant évalué en fin de période. Il faut résoudre une équation non linéaire, pour \(k'\), à chaque pas.
(S3) À facteurs composés : \((1+n\Delta)(1+x\Delta)k' = (1-\delta\Delta)k+s\Delta f(k)\), la forme retenue par McCandless, également close.
(S4) Exponentiel : \(k' = e^{-r\Delta}k+sf(k)\frac{1-e^{-r\Delta}}{r}\), exact si \(f(k)\) était constante sur la période.
Les schémas (S1), (S2) et (S4) procèdent de l'équation différentielle. (S3) n'en procède pas : il traduit une comptabilité. Sur une période, le capital survit au facteur \(1-\delta\), la population et la technologie croissent aux facteurs \(1+n\) et \(1+x\), et ces deux facteurs se composent. Le terme croisé qui en résulte n'est pas une erreur d'approximation, c'est le produit de deux croissances à l'intérieur d'une même période.
Le critère qui les sépare
Un critère formel départage les deux natures. Un schéma de discrétisation vise, par construction, le point de repos de l'équation qu'il approche : quelle que soit la longueur de la période, son point fixe est celui de l'équation différentielle. Vérifions, en itérant chaque écriture jusqu'à convergence.
| écriture | point fixe, \(\Delta=1\) | point fixe, \(\Delta=4\) |
|---|---|---|
| (S1) explicite | \(1{,}745960\) | \(1{,}745960\) |
| (S2) implicite | \(1{,}745960\) | \(1{,}745960\) |
| (S4) exponentiel | \(1{,}745960\) | \(1{,}745960\) |
| (S3) composé | \(1{,}738194\) | \(1{,}715233\) |
Trois des quatre tombent exactement sur \(\hat k^{\star} = 1{,}745960\), l'état stationnaire de l'équation différentielle, quelle que soit la période. (S3) non. Sa condition stationnaire s'écrit :
\[ sf(\hat k) = \bigl(n+x+\delta+nx\Delta\bigr)\,\hat k \]
son taux effectif dépend de la longueur de la période, et son état stationnaire s'en éloigne proportionnellement — de \(0{,}44\,\%\) à l'année, de \(1{,}76\,\%\) à quatre ans. Ce n'est pas un schéma imprécis, c'est un autre modèle.
Le même terme se retrouve dans la vitesse de convergence. L'identité \(1-B = \beta^{\star}/(1+n)\) de la section Vitesse de convergence devient, pour (S3) avec progrès technique,
\[ 1-B = \frac{(1-\alpha)\bigl[(1+n)(1+x)-(1-\delta)\bigr]}{(1+n)(1+x)} \]
qui dépasse \(\beta^{\star}/\bigl[(1+n)(1+x)\bigr]\) de \(0{,}29\,\%\) pour notre étalonnage.
La précision ne suit pas la rigueur apparente
On serait tenté de conclure que (S3), seul à manquer l'état stationnaire, est le moins bon. C'est l'inverse. L'erreur relative maximale sur quarante années, en partant de \(30\,\%\) de l'état stationnaire, vaut :
| \(\Delta\) | (S1) | (S2) | (S3) | (S4) |
|---|---|---|---|---|
| un an | \(1{,}2\times10^{-2}\) | \(1{,}2\times10^{-2}\) | \(7{,}0\times10^{-3}\) | \(1{,}7\times10^{-2}\) |
| deux ans | \(2{,}5\times10^{-2}\) | \(2{,}3\times10^{-2}\) | \(1{,}4\times10^{-2}\) | \(3{,}4\times10^{-2}\) |
| quatre ans | \(5{,}3\times10^{-2}\) | \(4{,}3\times10^{-2}\) | \(2{,}9\times10^{-2}\) | \(7{,}0\times10^{-2}\) |
| huit ans | \(1{,}1\times10^{-1}\) | \(7{,}6\times10^{-2}\) | \(6{,}0\times10^{-2}\) | \(1{,}4\times10^{-1}\) |
Les quatre sont d'ordre un, l'erreur doublant avec la longueur de la période. Mais (S3) est le plus précis des quatre sur la transition, et (S4) le moins — alors qu'il est le seul à traiter exactement la partie linéaire de l'équation. L'erreur est dominée non par ce terme mais par le fait de figer \(sf(k)\) sur toute la période, et la formulation qui traite le mieux l'un traite le moins bien l'autre. On ne peut donc pas reléguer (S3) au rang de convention grossière.
À l'année, tous restent sous le pour-cent : le choix de l'écriture est sans conséquence pratique pour un étalonnage usuel.
Il n'y a pas non plus de modèle discret « naturel »
Poussons d'un cran. Si la dépréciation et la démographie agissent continûment, les facteurs exacts sur une période ne sont pas ceux de (S3) :
| sur une année | convention de (S3) | facteur exact |
|---|---|---|
| survie du capital | \(1-\delta = 0{,}900000\) | \(e^{-\delta} = 0{,}904837\) |
| croissance de la population | \(1+n = 1{,}020000\) | \(e^{n} = 1{,}020201\) |
Un demi pour cent d'écart sur le capital survivant. Le \(1-\delta\) de la comptabilité discrète est donc lui aussi une convention, non une donnée. Il n'y a pas d'un côté le modèle vrai et de l'autre ses approximations, mais deux jeux d'hypothèses primitives dont il faut connaître les conséquences.
Le passage à la limite
Ce qui rapproche les deux familles est le raccourcissement de la période. Le terme croisé étant d'ordre \(\Delta^2\), rapporté à l'année il s'efface proportionnellement à \(\Delta\) :
| longueur de la période | écart par année |
|---|---|
| un an | \(4{,}0\times10^{-4}\) |
| un trimestre | \(1{,}0\times10^{-4}\) |
| un mois | \(3{,}3\times10^{-5}\) |
| \(0{,}01\) an | \(4{,}0\times10^{-6}\) |
C'est là tout le contenu de l'expression « passage à la limite continue ». Elle dit que les deux familles se rejoignent, non que l'une soit la vérité de l'autre.
Ce que rapporte le schéma implicite
Le coût de l'implicite, une équation non linéaire par pas, a été vu plus haut. Reste son bénéfice, qui n'apparaît que si l'on allonge la période. Le choix de l'écriture, sans conséquence à l'année, cesse de l'être alors. Le schéma implicite tombe sur l'état stationnaire quelle que soit la longueur de la période, y compris cent ans, là où le schéma explicite s'égare puis diverge :
| \(\Delta\) | explicite | implicite |
|---|---|---|
| \(25\) ans | \(2{,}64\) | \(1{,}7460\) |
| \(40\) ans | diverge | \(1{,}7460\) |
| \(100\) ans | diverge | \(1{,}7460\) |
C'est la propriété de stabilité inconditionnelle du schéma d'Euler rétrograde, payée d'une équation non linéaire à résoudre à chaque pas. Une mise en garde pour finir : lorsque le solveur ne converge pas, le résultat ressemble beaucoup à un modèle qui se comporte mal. Il vaut la peine de contrôler le résidu plutôt que de se fier à la trajectoire.
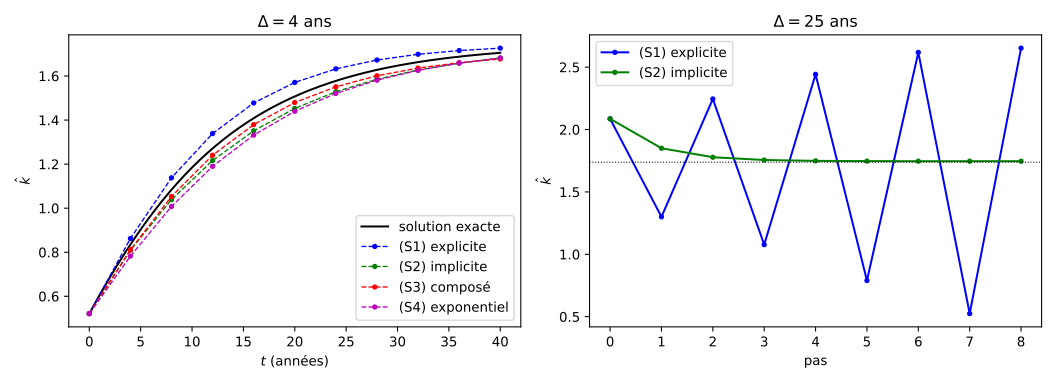
Figure 5 : Les quatre écritures. À gauche la précision, à droite la stabilité.
Calibrage
Le modèle compte quatre paramètres, \(\alpha\), \(s\), \(n\) et \(\delta\), auxquels s'ajoutent \(x\) et la variance du choc dans la version stochastique. Les fixer demande de distinguer deux catégories.
Ce qui ne dépend pas de la période. Le taux d'épargne \(s\) et la part du capital \(\alpha\) sont des ratios, sans dimension. Ils sont les mêmes à l'année et au trimestre. La part du capital se lit dans les comptes nationaux, autour de \(0{,}30\) à \(0{,}36\) selon le traitement des revenus mixtes ; le taux d'épargne se lit dans le taux d'investissement, autour de \(0{,}20\) à \(0{,}22\).
Ce qui en dépend. Les taux \(n\), \(x\) et \(\delta\) s'expriment par période. Le passage de l'année au trimestre se fait par \((1+r)^{1/4}-1\), et non par \(r/4\) : pour \(\delta = 0{,}10\), on obtient \(0{,}0241\) contre \(0{,}0250\), soit une approximation qui dévie de près de \(4\,\%\). L'écart est négligeable pour \(n\) et \(x\), où les taux sont petits, et ne l'est pas pour \(\delta\).
Reste le point le plus important, et le plus souvent passé sous silence.
Le long du sentier de croissance équilibrée, le ratio du capital à la production est entièrement déterminé par les autres paramètres :
\[ \frac{K}{Y} = \frac{s}{n+x+nx+\delta} \]
En unités d'efficience, la condition de sentier équilibré s'écrit \(sf(\hat k) = (n+x+nx+\delta)\hat k\), soit \(s\hat y = (n+x+nx+\delta)\hat k\). Le ratio \(\hat k/\hat y\) étant égal à \(K/Y\), qui est invariant par changement d'unités, le résultat suit.
Cette identité lie cinq grandeurs, dont quatre sont observables. On ne peut donc pas les choisir librement. Avec l'étalonnage de McCandless, \(s = 0{,}20\), \(n = 0{,}02\) et \(\delta = 0{,}10\), elle impose \(K/Y = 1{,}42\), alors que les données suggèrent une valeur comprise entre \(2{,}5\) et \(3\). Inversement, viser \(K/Y = 3\) avec \(s = 0{,}20\) et \(n+x = 0{,}04\) impose \(\delta = 0{,}027\), bien loin des dix pour cent usuels.
Il n'y a pas là d'erreur, mais un arbitrage. Calibrer, c'est choisir quels moments on accepte de rater. Un étalonnage retenant \(\delta = 0{,}10\) vise la dynamique de court terme, où la dépréciation gouverne la vitesse d'ajustement ; un étalonnage retenant \(K/Y = 3\) vise les grandeurs de long terme. Le modèle de Solow n'a pas assez de degrés de liberté pour les atteindre simultanément, et c'est une information sur le modèle, pas sur la méthode.
Une version stochastique
Rendons la technologie aléatoire. Parmi les formulations possibles, la plus commode retient un niveau de technologie log-normal,
\[ A_t = \bar Ae^{\varepsilon_t} \]
où \(\varepsilon_t\) est un bruit blanc gaussien centré d'écart-type \(\sigma_{\varepsilon}\). Cette écriture garantit la positivité de \(A_t\), ce que ne ferait pas un choc additif. La loi d'évolution devient
\[ k_{t+1} = \frac{(1-\delta)k_t + s\bar Ae^{\varepsilon_t}f(k_t)}{1+n} \]
Elle reste explicite : simuler le modèle non linéaire ne demande rien de plus qu'une boucle. C'est le confort du schéma explicite, et c'est aussi ce qui distingue le modèle de Solow des modèles à anticipations, où la trajectoire doit être résolue globalement.
def simule_exact(T, sigma, graine=0):
    """Simulation du modèle non linéaire. Le capital est prédéterminé :
    le choc de la période t n'affecte le capital qu'en t+1."""
    alea = np.random.default_rng(graine)
    eps = sigma*alea.standard_normal(T)
    k = np.empty(T)
    k[0] = kstar()
    for t in range(T-1):
        k[t+1] = ((1-delta)*k[t] + s*A*np.exp(eps[t])*f(k[t]))/(1+n)
    y = A*np.exp(eps)*f(k)
    return k, y, eps
La datation est le seul point délicat. Le capital \(k_t\) est décidé en \(t-1\) : il ne dépend pas de \(\varepsilon_t\). La production \(y_t\), elle, subit le choc contemporain. Inverser ces deux lignes conduit à surestimer la variance de la production de près de dix pour cent, sans que rien ne le signale.
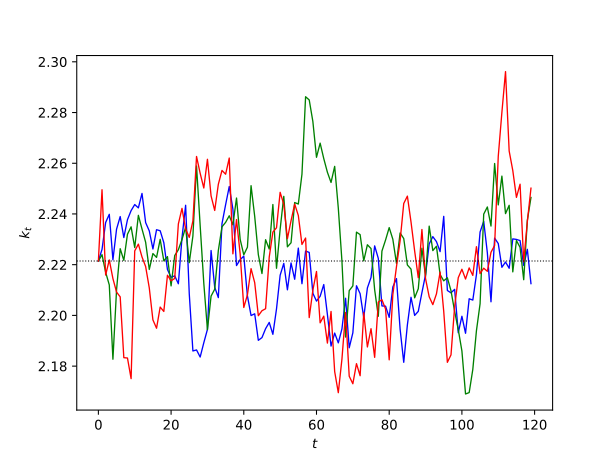
Figure 6 : Trois simulations du modèle non linéaire, avec \(\sigma_{\varepsilon}=0{,}05\).
Log-linéarisation
Le modèle étant non linéaire, la variance du capital ne s'exprime pas simplement en fonction de celle du choc. On approche donc le modèle au voisinage de l'état stationnaire. En notant \(\tilde X_t = \log X_t - \log\bar X\), et en utilisant \(e^{\tilde X}\simeq 1+\tilde X\) ainsi que \(\tilde X\tilde Y\simeq 0\), la loi d'évolution devient
\[ \tilde k_{t+1} = B\tilde k_t + C\varepsilon_t, \qquad B = \frac{(1-\delta)+\alpha(n+\delta)}{1+n}, \qquad C = \frac{n+\delta}{1+n} \]
Deux remarques. D'abord, le taux d'épargne n'apparaît ni dans \(B\) ni dans \(C\) : il s'élimine par la condition d'état stationnaire. Un pays qui épargne davantage est plus riche, mais ne converge ni plus vite ni plus lentement, et ne réagit pas différemment aux chocs. Ensuite, \(\tilde k\) est un processus autorégressif d'ordre un ; sa représentation moyenne mobile s'obtient donc par la méthode exposée dans la note sur la représentation MA d'un AR(2), dont c'est le cas particulier à une seule racine :
\[ \tilde k_{t+1} = C\sum_{i=0}^{\infty}B^i\varepsilon_{t-i} \]
Les chocs étant indépendants, la variance s'en déduit immédiatement :
\[ \mathrm{var}\bigl(\tilde k\bigr) = \frac{C^2}{1-B^2}\,\mathrm{var}(\varepsilon) \]
La production, elle, subit le choc contemporain et hérite du capital prédéterminé, \(\tilde y_t = \varepsilon_t+\alpha\tilde k_t\), d'où
\[ \mathrm{var}\bigl(\tilde y\bigr) = \mathrm{var}(\varepsilon)+\alpha^2\,\mathrm{var}\bigl(\tilde k\bigr) \]
Pour notre étalonnage, \(\mathrm{var}(\tilde k) = 0{,}0955\,\mathrm{var} (\varepsilon)\) et \(\mathrm{var}(\tilde y) = 1{,}0124\,\mathrm{var} (\varepsilon)\).
def simule_loglineaire(T, sigma, graine=0):
    """Simulation de la version log-linéaire, avec les mêmes chocs."""
    alea = np.random.default_rng(graine)
    eps = sigma*alea.standard_normal(T)
    B = ((1-delta) + alpha*(n+delta))/(1+n)
    C = (n+delta)/(1+n)
    kt = np.zeros(T)
    for t in range(T-1):
        kt[t+1] = B*kt[t] + C*eps[t]
    yt = eps + alpha*kt
    return kt, yt, eps
Reste à savoir ce que vaut l'approximation. La figure ci-dessous compare, à gauche, les deux trajectoires sur un même tirage de chocs et, à droite, l'écart moyen entre elles en fonction de l'ampleur du choc.
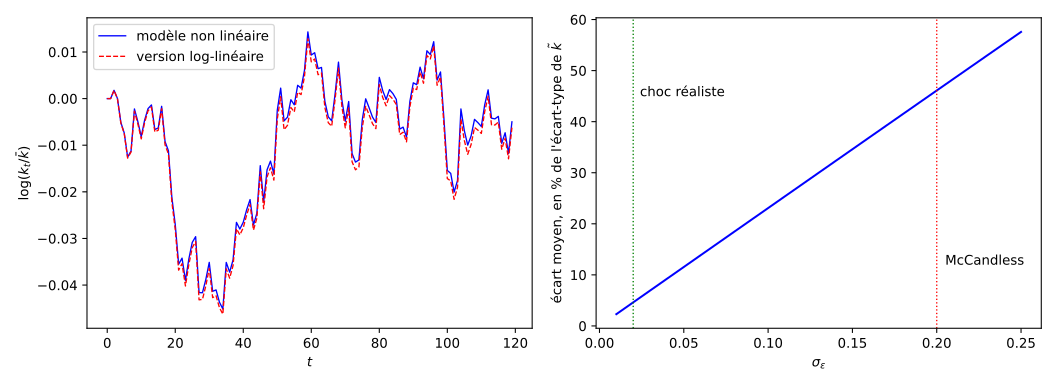
Figure 7 : Modèle non linéaire et version log-linéaire. À droite, l'erreur d'approximation croît avec l'ampleur du choc.
L'erreur relative croît proportionnellement à \(\sigma_{\varepsilon}\), et l'erreur absolue comme son carré. Rapportée à l'écart-type de \(\tilde k\), elle vaut \(4{,}6\,\%\) pour \(\sigma_{\varepsilon} = 0{,}02\), \(23\,\%\) pour \(\sigma_{\varepsilon} = 0{,}10\) et \(46\,\%\) pour \(\sigma_{\varepsilon} = 0{,}20\). C'est une information à garder en tête : pour un choc technologique d'ampleur réaliste la log-linéarisation est excellente, mais elle se dégrade vite. Les figures de McCandless retiennent \(\sigma_{\varepsilon} = 0{,}20\), ce qui les rend lisibles au prix d'une approximation poussée bien au-delà de son domaine de validité.
Ce que le modèle ne sait pas faire
Le calcul précédent contient un aveu. La variance de la production vaut \(1{,}0124\) fois celle du choc : le modèle ne fabrique presque aucune propagation. Toute la dynamique observée de la production est celle du choc lui-même, et le capital n'y ajoute que \(1{,}24\,\%\). Avec des chocs indépendants, la production est pratiquement un bruit blanc, ce que les données démentent nettement.
Une réponse consiste à rendre les chocs persistants, mais elle déplace la question sans y répondre : la persistance devient une hypothèse au lieu d'un résultat. Voyons plutôt ce qu'apporte un mécanisme interne.
Une rigidité sur l'ajustement de l'investissement
Supposons que l'investissement ne rejoigne sa cible que graduellement :
\[ i_t = (1-\varphi)\,i_{t-1} + \varphi\,s\,y_t \]
Le paramètre \(\varphi\in\,]0,1]\) mesure la vitesse d'ajustement, la valeur \(\varphi = 1\) redonnant le modèle de base. L'état stationnaire est inchangé, puisque \(\bar\imath = s\bar y\) y reste vérifié : la rigidité est purement dynamique.
En log-linéarisant, et en notant que \(\bar\imath = (n+\delta)\bar k\), le système devient
\begin{cases} \tilde k_{t+1} &= \dfrac{(1-\delta)\tilde k_t+(n+\delta)\tilde\imath_t}{1+n}\\[2mm] \tilde\imath_t &= (1-\varphi)\tilde\imath_{t-1}+\varphi\alpha\tilde k_t+\varphi\varepsilon_t \end{cases}Le système est de dimension deux : le capital suit désormais un processus autorégressif d'ordre deux, dont l'analyse relève exactement de la note sur la représentation MA d'un AR(2).
Ce que la rigidité apporte, et ce qu'elle n'apporte pas
Le tableau suivant donne les racines du système, la variance de la production et sa fonction d'autocorrélation, pour quelques valeurs de \(\varphi\).
| \(\varphi\) | racines | \(\mathrm{var}(\tilde y)\) | \(\rho_1\) | \(\rho_2\) | \(\rho_4\) | \(\rho_8\) |
|---|---|---|---|---|---|---|
| \(1{,}00\) | \(0{,}000\) et \(0{,}925\) | \(1{,}0121\) | \(0{,}053\) | \(0{,}050\) | \(0{,}042\) | \(0{,}031\) |
| \(0{,}50\) | \(0{,}475\) et \(0{,}928\) | \(1{,}0105\) | \(0{,}031\) | \(0{,}040\) | \(0{,}040\) | \(0{,}033\) |
| \(0{,}30\) | \(0{,}662\) et \(0{,}933\) | \(1{,}0091\) | \(0{,}021\) | \(0{,}030\) | \(0{,}034\) | \(0{,}032\) |
| \(0{,}10\) | \(0{,}831\) et \(0{,}955\) | \(1{,}0055\) | \(0{,}010\) | \(0{,}014\) | \(0{,}017\) | \(0{,}021\) |
Le résultat n'est pas celui qu'on espérait. La rigidité n'augmente ni la variance ni la persistance : la variance baisse légèrement et l'autocorrélation d'ordre un s'effondre. Ce qu'elle change, c'est la forme de la propagation. L'autocorrélation cesse de décroître pour devenir en cloche : à \(\varphi = 0{,}30\), on lit \(\rho_1 < \rho_2 < \rho_4\). La réponse impulsionnelle se déforme de la même manière, son maximum passant du premier retard au cinquième.
La rigidité redistribue la propagation dans le temps, elle ne l'amplifie pas. C'est un enseignement plus utile que celui qu'on cherchait : elle produit le délai de transmission qui manque au modèle de Solow, mais elle n'accroît pas la persistence.
def systeme_rigide(phi):
    """Matrices du système log-linéaire (k~, i~) avec ajustement partiel."""
    a = ((1-delta) + (n+delta)*phi*alpha)/(1+n)
    b = (n+delta)*(1-phi)/(1+n)
    M = np.array([[a, b], [phi*alpha, 1-phi]])
    N = np.array([(n+delta)*phi/(1+n), phi])
    return M, N

def reponse(phi, H=12):
    """Réponse de la production à un choc unitaire."""
    M, N = systeme_rigide(phi)
    etat, sortie = N.copy(), [1.0]
    for _ in range(H):
        sortie.append(alpha*etat[0])
        etat = M @ etat
    return np.array(sortie)
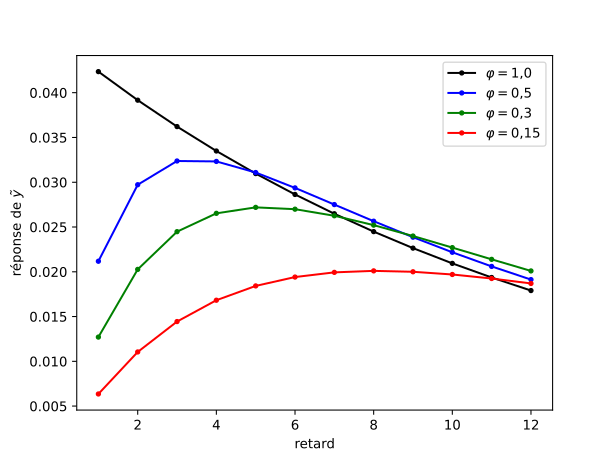
Figure 8 : Réponse de la production à un choc technologique, hors impact. La rigidité déplace le maximum vers les retards éloignés.
Le lien avec la note sur l'AR(2) est direct. Les deux racines sont réelles, et la bosse de la réponse impulsionnelle est exactement le phénomène décrit dans sa section sur les racines confondues : à \(\varphi = 0{,}10\) les racines valent \(0{,}83\) et \(0{,}96\), presque égales, et la réponse s'apparente à la suite \((k+1)\rho^k\).
Cette proximité n'est pas fortuite, et elle indique aussi la limite du mécanisme.
Quel que soit \(\varphi\in\,]0,1[\), les deux racines du système sont réelles : une rigidité sur l'investissement ne peut pas engendrer d'oscillations.
En notant \(a\), \(b\), \(c\) et \(d\) les coefficients de la matrice du système, le discriminant de son polynôme caractéristique vaut \((a+d)^2-4(ad-bc) = (a-d)^2+4bc\). Or \(b = (n+\delta)(1-\varphi)/(1+n)>0\) et \(c = \varphi\alpha>0\) pour \(\varphi<1\). Le discriminant est donc strictement positif.
Toutes les rétroactions du modèle sont positives, et c'est cela qui interdit les cycles. Pour obtenir des racines complexes, il faudrait que l'investissement réagisse à la variation de la production plutôt qu'à son niveau, c'est-à-dire un accélérateur à la Samuelson, \(i_t = sy_t + v(y_t-y_{t-1})\). On sort alors du modèle de Solow.
Vers les modèles de cycles réels
Le modèle de Solow échoue à reproduire les fluctuations pour deux raisons distinctes, qu'il vaut la peine de séparer. Il n'a pas de mécanisme de propagation, on vient de le voir, et une rigidité ad hoc ne fait que déplacer le problème. Mais surtout, le taux d'épargne y est postulé constant : rien, dans le modèle, ne décrit le choix des ménages entre consommer et investir, ni entre travailler et ne pas travailler.
C'est précisément ce que les modèles de cycles réels ajoutent. Ils remplacent la règle d'épargne par un programme intertemporel, rendent l'offre de travail endogène, et donnent aux chocs technologiques une persistance estimée sur les données. Le modèle de Solow en temps discret reste le point de départ de cette construction, et c'est à ce titre qu'il ouvre les manuels du domaine.
Références
Le fil de cette note suit le premier chapitre de McCandless, G. (2008), The ABCs of RBCs: An Introduction to Dynamic Macroeconomic Models, Harvard University Press, où le modèle de Solow en temps discret sert d'introduction aux modèles de cycles réels. Les sections sur la discrétisation, le calibrage et la rigidité sur l'investissement en sont des prolongements.
Sur le modèle de Solow en temps continu, on se reportera aux notes sur le modèle de Solow et sur sa simulation. Sur les représentations moyenne mobile utilisées aux deux dernières sections, voir la note sur la représentation MA d'un AR(2). La référence classique sur la théorie de la croissance reste Barro, R. et Sala-i-Martin, X. (2004), Economic Growth, MIT Press.
Notes de bas de page:
Dans le modèle de Solow il n'y a pas d'anticipations.