Pour estimer le modèle de Solow, Mankiw, Romer et Weil (1992) supposent que toutes les économies convergent à la même vitesse vers leur sentier de croissance équilibrée. Le modèle dit pourtant le contraire : la vitesse de convergence, \((1-\alpha)(n+x+\delta)\), dépend de la croissance démographique et du taux de dépréciation, qui diffèrent d'un pays à l'autre. Cette note l'estime par le maximum de vraisemblance, qui exploite la forme de l'hétéroscédasticité que le modèle implique, avec une part du capital commune et une vitesse propre à chaque pays, sur les Penn World Tables (110 pays, 1960-2023). Les vitesses propres n'améliorent guère l'ajustement, et le modèle de Solow complet est rejeté : la part du capital qui rend compte des écarts de revenu implique une convergence trois fois plus rapide que celle que l'on estime. Une simulation montre toutefois que ce rejet peut venir d'un biais d'endogénéité, qu'une estimation en coupe ne permet pas de lever. Les calculs sont faits en Python, et les corrigés des exercices sont donnés dans des blocs dépliables.
La régression de Mankiw, Romer et Weil
On reprend le modèle de Solow avec une fonction de production Cobb-Douglas, dans les notations de la note sur la simulation du modèle de Solow : \(s\) est le taux d'épargne, \(n\) le taux de croissance de la population, \(x\) celui de l'efficacité du travail \(A\), \(\delta\) le taux de dépréciation et \(\alpha\) l'élasticité de la production au capital. Au voisinage du sentier de croissance équilibrée, l'écart de la production par tête efficace \(\hat y = y/A\) à sa valeur stationnaire se résorbe au taux \(\beta = (1-\alpha)(n+x+\delta)\), la vitesse de convergence : \(\log\hat y(t) - \log\hat y^{\star} \approx e^{-\beta t}\bigl(\log\hat y(0) - \log\hat y^{\star}\bigr)\). En revenant au revenu par tête \(y\), avec \(A(t) = A(0)e^{xt}\), le taux de croissance annuel moyen entre les dates \(0\) et \(t\) s'écrit
\begin{equation*} \bar g_{y}(0,t) \equiv \frac{\log y(t) - \log y(0)}{t} = x + \frac{1-e^{-\beta t}}{t}\Bigl(\log\hat y^{\star} + \log A(0) - \log y(0)\Bigr) \end{equation*}où \(\log\hat y^{\star} = \frac{\alpha}{1-\alpha}\bigl(\log s - \log(n+x+\delta)\bigr)\). L'efficacité initiale du travail n'est pas observée : on écrit, pour le pays \(i\), \(\log A_i(0) = a + \varepsilon_i\), où \(\varepsilon_i\) est une perturbation d'espérance nulle.
Si la vitesse de convergence est la même dans tous les pays, le facteur \((1-e^{-\beta t})/t\) est une constante et l'équation de croissance est linéaire :
\begin{equation*} \bar g_{y,i} = a_0 + a_1\log y_i(0) + a_2\log s_i + a_3\log(n_i+x+\delta) + u_i \end{equation*}avec \(a_1 = -(1-e^{-\beta t})/t\), \(a_2 = -a_1\alpha/(1-\alpha)\), \(a_3 = -a_2\) et \(u_i = -a_1\varepsilon_i\). C'est la régression de convergence conditionnelle de Mankiw, Romer et Weil (1992), que l'on estime par les moindres carrés ordinaires (MCO). On en déduit la vitesse de convergence, \(\hat\beta = -\log(1 + t\hat a_1)/t\). Pour calculer \(\log(n_i + x + \delta)\), les trois auteurs imposent \(x + \delta = 0{,}05\) dans tous les pays, et s'en expliquent ainsi (p. 410) :
We assume that g and δ are constant across countries. g reflects primarily the advancement of knowledge, which is not country-specific. And there is neither any strong reason to expect depreciation rates to vary greatly across countries, nor are there any data that would allow us to estimate country-specific depreciation rates.
Or la vitesse de convergence dépend de \(n_i\), qui varie d'un pays à l'autre, et les Penn World Tables (PWT) fournissent aujourd'hui un taux de dépréciation par pays. Commençons par reproduire l'estimation. Le code suivant lit la feuille de données du classeur Excel de la version 11.0 des PWT, qui couvre 185 pays entre 1950 et 2023.
pwt = pd.read_excel('pwt110.xlsx', 'Data')
Comme dans le cours, nous retenons la période 1960-2023 et les pays pour
lesquels le PIB, rgdpo, la population, pop, et la part de l'investissement
dans le PIB, csh_i, sont renseignés toutes les années. Pour chaque pays, le
revenu par tête est le rapport du PIB à la population, le taux d'épargne est
la moyenne de csh_i sur la période, le taux de croissance de la population
est son taux annuel moyen entre 1960 et 2023, et le taux de dépréciation est
la moyenne de delta, le taux moyen de dépréciation du capital. Le cours
mesure la croissance du revenu par tête par son taux annuel moyen,
\((y(t)/y(0))^{1/t} - 1\), que nous gardons pour reproduire ses résultats, et
nous calculons aussi la log-différence de l'équation de croissance.
DEBUT, FIN = 1960, 2023
t = FIN - DEBUT
donnees = (pwt[(pwt['year'] >= DEBUT) & (pwt['year'] <= FIN)]
           .set_index(['countrycode', 'year'])[['rgdpo', 'pop', 'csh_i', 'delta']]
           .sort_index())
renseigne = donnees.notna().groupby('countrycode').sum() == t + 1

def resume(pays):
    y = (pays['rgdpo']/pays['pop']).to_numpy()
    population = pays['pop'].to_numpy()
    return pd.Series({'y0': y[0],
                      's': pays['csh_i'].mean(),
                      'n': (population[-1]/population[0])**(1/t) - 1,
                      'delta': pays['delta'].mean(),
                      'g_geo': (y[-1]/y[0])**(1/t) - 1,
                      'g': np.log(y[-1]/y[0])/t})

retenus = renseigne[['rgdpo', 'pop', 'csh_i']].all(axis=1)
pays = donnees.loc[retenus[retenus].index].groupby('countrycode').apply(resume)
pays = pays[pays['s'] > 0]
pays['avec_delta'] = renseigne.loc[pays.index, 'delta']
print(len(pays), list(pays.index[~pays['avec_delta']]))
L'échantillon compte 111 pays. La fonction suivante calcule l'estimateur des MCO et sa matrice de variance, avec la normalisation du cours (la somme des carrés des résidus, SCR, est divisée par le nombre d'observations, sans correction des degrés de liberté).
def mco(X, y):
    b = np.linalg.solve(X.T @ X, X.T @ y)
    e = y - X @ b
    V = np.linalg.inv(X.T @ X)*(e @ e)/len(y)
    return b, V, e @ e

def vitesse(a1):
    return -np.log(1 + t*a1)/t

X = np.column_stack([np.ones(len(pays)), np.log(pays['y0']),
                     np.log(pays['s']), np.log(pays['n'] + 0.05)])
b, V, _ = mco(X, pays['g_geo'].to_numpy())
R = np.array([0, 0, 1, 1])
print(b.round(4), (b/np.sqrt(np.diag(V))).round(2))
print(vitesse(b[1]), R @ b/np.sqrt(R @ V @ R))
On retrouve les résultats du cours : \(\hat a_1 = -0{,}0097\), avec une statistique de Student de \(-5{,}86\), soit une vitesse de convergence de 1,5 % par an, et la contrainte \(a_2 + a_3 = 0\) est rejetée (la statistique de Student de \(\hat a_2 + \hat a_3\) vaut \(-3{,}91\)).
Le taux de dépréciation n'est pas renseigné toutes les années pour la Guinée équatoriale : dans la suite, l'échantillon compte 110 pays, et le taux de croissance est mesuré par la log-différence, qui est la grandeur exacte de l'équation de croissance. Avec ces deux changements, la vitesse estimée par les MCO passe de 1,51 % à 1,43 % par an. Nous fixons \(x = 0{,}02\), la valeur retenue par Mankiw, Romer et Weil, et gardons pour chaque pays son taux de croissance démographique et son taux de dépréciation.
echantillon = pays[pays['avec_delta']]
g, s, n, delta = (echantillon[v].to_numpy() for v in ('g', 's', 'n', 'delta'))
ly0 = np.log(echantillon['y0'].to_numpy())
N, x = len(g), 0.02
c = n + x + delta
codes = echantillon.index
print(N, np.median(delta), delta.min(), codes[delta.argmin()], delta.max(), codes[delta.argmax()])
print(n.min(), n.max(), np.std(n), np.std(delta), np.corrcoef(n, delta)[0, 1])
print(np.corrcoef(g, n)[0, 1], np.corrcoef(g, delta)[0, 1], np.corrcoef(g, np.log(c))[0, 1])
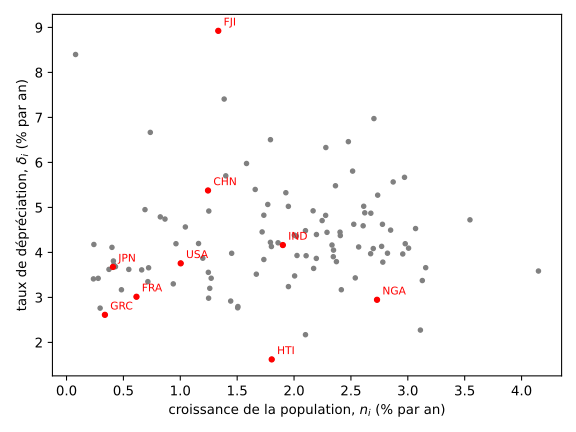
Le taux de dépréciation médian est de 4,1 %, et va de 1,6 % en Haïti à 8,9 % aux Fidji. Il varie davantage que le taux de croissance de la population (écart-type de 1,2 point contre 0,9), et les deux ne sont guère corrélés. Dans ces données, les différences de vitesse de convergence entre pays viennent donc surtout de la dépréciation, que Mankiw, Romer et Weil supposaient commune.
Des vitesses de convergence propres à chaque pays
Si l'on prend le modèle au sérieux, la vitesse de convergence du pays \(i\) est \(\beta_i = (1-\alpha)(n_i+x+\delta_i)\), et l'équation de croissance devient
\begin{equation*} \bar g_{y,i} = x + \frac{1-e^{-\beta_i t}}{t}\left(a + \frac{\alpha}{1-\alpha}\bigl(\log s_i - \log(n_i+x+\delta_i)\bigr) - \log y_i(0)\right) + u_i \end{equation*}avec \(u_i = \varepsilon_i(1-e^{-\beta_i t})/t\). Le facteur qui multiplie la parenthèse change d'un pays à l'autre et dépend de \(\alpha\) : l'équation n'est plus linéaire dans les paramètres, et les MCO ne s'appliquent plus. Il n'y a pourtant que deux paramètres à estimer, \(\alpha\) et \(a\), puisque la vitesse de chaque pays se déduit de \(\alpha\) et de ses propres \(n_i\) et \(\delta_i\). Nous n'avons pas besoin d'estimer 110 vitesses de convergence.
En divisant l'équation par \((1-e^{-\beta_i t})/t\), on obtient
\begin{equation*} \frac{t(\bar g_{y,i} - x)}{1-e^{-\beta_i t}} + \log y_i(0) = a + \frac{\alpha}{1-\alpha}\bigl(\log s_i - \log(n_i+x+\delta_i)\bigr) + \varepsilon_i \end{equation*}Lorsque \(\beta_i t\) est grand, le membre de gauche tend vers \(\log y_i(t) - xt\) : on retrouve la régression en niveau de Mankiw, Romer et Weil, qui explique le revenu par tête d'un pays supposé à son état stationnaire. L'équation de croissance tient compte, en plus, du chemin qui reste à parcourir. Cette écriture éclaire le modèle, mais elle ne fournit pas un bon estimateur : le membre de gauche dépend de \(\alpha\), et minimiser la somme des carrés de ses résidus conduit à surestimer la vitesse de convergence (voir l'exercice 4).
L'estimation
Les moindres carrés non linéaires
Notons \(\theta\) le vecteur des paramètres et \(f_i(\theta)\) le taux de croissance que le modèle prédit pour le pays \(i\). L'estimateur des moindres carrés non linéaires (MCNL) minimise, comme celui des MCO, la somme des carrés des résidus :
\begin{equation*} \hat\theta = \arg\min_{\theta}\;\mathrm{SCR}(\theta) = \sum_{i=1}^{N}\bigl(\bar g_{y,i} - f_i(\theta)\bigr)^2 \end{equation*}Les MCO en sont le cas particulier où \(f_i(\theta)\) est linéaire en \(\theta\). Les conditions du premier ordre, \(\sum_i \frac{\partial f_i}{\partial\theta}(\hat\theta)\bigl(\bar g_{y,i} - f_i(\hat\theta)\bigr) = 0\), forment cette fois un système non linéaire, sans solution explicite. On le résout par itérations. L'algorithme de Gauss-Newton remplace, au point \(\theta_k\), la fonction \(f\) par son approximation linéaire \(f(\theta_k) + J_k(\theta - \theta_k)\), où \(J_k\) est la matrice des dérivées \(\partial f_i/\partial\theta\) (la jacobienne), puis applique les MCO :
\begin{equation*} \theta_{k+1} = \theta_k + (J_k'J_k)^{-1}J_k'\bigl(\bar g_y - f(\theta_k)\bigr) \end{equation*}
La jacobienne joue le rôle de la matrice des régresseurs : à la
convergence, la variance de l'estimateur est estimée, comme pour les MCO, par
\(\hat\sigma^2(J'J)^{-1}\), avec \(\hat\sigma^2 = \mathrm{SCR}(\hat\theta)/N\).
Nous utilisons la fonction least_squares de SciPy, qui perfectionne cet
algorithme, et nous la lançons depuis plusieurs points de départ pour nous
assurer que le minimum trouvé est bien le plus bas.
Le maximum de vraisemblance
Le terme d'erreur, \(u_i = \varepsilon_i w_i(\theta)\) avec \(w_i(\theta) = (1-e^{-\beta_i t})/t\), n'a pas la même variance dans tous les pays. Mais nous n'avons pas à traiter cette hétéroscédasticité comme une nuisance de forme inconnue : c'est le modèle qui la produit, et il en donne la forme exacte, \(\mathbb{V}(u_i) = \sigma^2w_i(\theta)^2\). Autant s'en servir. Si les \(\varepsilon_i\) sont normales et indépendantes, la log-vraisemblance s'écrit, à une constante près,
\begin{equation*} \ell(\theta,\sigma^2) = -\frac{N}{2}\log\sigma^2 - \sum_{i=1}^{N}\log w_i(\theta) - \frac{1}{2\sigma^2}\sum_{i=1}^{N}\left(\frac{\bar g_{y,i} - f_i(\theta)}{w_i(\theta)}\right)^2 \end{equation*}En y remplaçant \(\sigma^2\) par l'estimateur qui la maximise, \(\hat\sigma^2(\theta) = \frac{1}{N}\sum_i\bigl((\bar g_{y,i} - f_i(\theta))/w_i(\theta)\bigr)^2\), on obtient le critère concentré
\begin{equation*} \ell(\theta) = -\frac{N}{2}\log\left(\frac{1}{N}\sum_{i=1}^{N}\left(\frac{\bar g_{y,i} - f_i(\theta)}{w_i(\theta)}\right)^2\right) - \sum_{i=1}^{N}\log w_i(\theta) \end{equation*}Il comporte deux termes. Le premier est la somme des carrés des résidus pondérés par l'inverse de leur écart-type : chaque pays compte d'autant plus que son erreur est réputée petite. Le second pénalise les valeurs de \(\theta\) qui gonflent ces écarts-types. Sans lui, la pondération seule attirerait l'estimateur vers les vitesses élevées, puisqu'il suffirait de diviser par de grands nombres pour réduire le critère (voir l'exercice 4).
Lorsque la vitesse de convergence est commune, \(w_i\) ne dépend plus de \(i\) et les deux termes se compensent exactement : le critère se réduit à \(-\frac{N}{2}\log\bigl(\mathrm{SCR}(\theta)/N\bigr)\), que maximise l'estimateur des MCO. Le maximum de vraisemblance ne s'écarte donc des MCO de Mankiw, Romer et Weil que par ce que les vitesses propres à chaque pays ajoutent, et les cinq spécifications se comparent par la même log-vraisemblance.
Nous maximisons \(\ell\) numériquement, avec minimize de SciPy, en partant de
l'estimation des MCNL. Les écarts-types sont les racines de la diagonale de
l'inverse de la hessienne de \(-\ell\), calculée par différences finies. Nous les
comparons à des écarts-types robustes à l'hétéroscédasticité, calculés sur les
résidus pondérés : si le modèle dit vrai sur la forme de la variance, les
deux doivent être proches. Les contraintes se testent par un rapport de
vraisemblance, \(2\bigl(\ell(\hat\theta) - \ell(\tilde\theta)\bigr)\), qui suit
une loi du \(\chi^2\) à un degré de liberté sous l'hypothèse testée.
Nous comparons quatre spécifications. M0' et M1 ont le même nombre de paramètres ; les trois dernières sont emboîtées, chacune ajoutant une contrainte à la précédente :
- M0' : la régression de Mankiw, Romer et Weil, estimée par les MCO avec \(\log(n_i + x + \delta_i)\) au lieu de \(\log(n_i + 0{,}05)\) (et M0, la régression d'origine, sur le même échantillon) ;
- M1 : la même équation, mais avec une vitesse propre à chaque pays, \(\beta_i = \theta(n_i+x+\delta_i)\), où \(\theta\) est un paramètre libre, et des coefficients libres pour \(\log s_i\) et \(\log(n_i+x+\delta_i)\) dans la parenthèse. Seule la structure des vitesses change par rapport à M0' ;
- M2 : M1 avec des coefficients opposés pour \(\log s_i\) et \(\log(n_i+x+\delta_i)\), égaux à \(\pm\alpha/(1-\alpha)\), comme dans le modèle de Solow ;
- M3 : M2 avec \(\theta = 1-\alpha\), c'est-à-dire le modèle de Solow complet, où la même élasticité \(\alpha\) fixe l'état stationnaire et la vitesse de convergence.
def croissance(p, modele, ly0):
    """Taux de croissance prédit par une spécification, pour les paramètres p."""
    if modele == 'M1':
        theta, a, a2, a3 = p
    elif modele == 'M2':
        theta, a, alpha = p
        a2, a3 = alpha/(1 - alpha), -alpha/(1 - alpha)
    else:
        a, alpha = p
        theta, a2, a3 = 1 - alpha, alpha/(1 - alpha), -alpha/(1 - alpha)
    w = 1 - np.exp(-theta*c*t)
    return x + w/t*(a + a2*np.log(s) + a3*np.log(c) - ly0)

BORNES = {'M1': ([1e-4, -np.inf, -np.inf, -np.inf], [3, np.inf, np.inf, np.inf]),
          'M2': ([1e-4, -np.inf, 0.01], [3, np.inf, 0.99]),
          'M3': ([-np.inf, 0.01], [np.inf, 0.99])}

def mcnl(modele, g, ly0, departs):
    """Estimateur des MCNL, le meilleur de plusieurs points de départ."""
    residus = lambda p: g - croissance(p, modele, ly0)
    essais = [least_squares(residus, p0, bounds=BORNES[modele]) for p0 in departs]
    return min(essais, key=lambda e: e.cost), essais

def poids(p, modele):
    """Écart-type relatif de l'erreur du pays i, w_i(theta)."""
    theta = p[0] if modele != 'M3' else 1 - p[1]
    return (1 - np.exp(-theta*c*t))/t

def logv(p, modele, g, ly0):
    """Log-vraisemblance concentrée, à une constante près."""
    w = poids(p, modele)
    u = (g - croissance(p, modele, ly0))/w
    return -N/2*np.log(u @ u/N) - np.sum(np.log(w))

def maxv(modele, g, ly0, depart):
    """Maximum de vraisemblance, à partir de l'estimation des MCNL."""
    bornes = [(max(lo, -50), min(hi, 50)) for lo, hi in zip(*BORNES[modele])]
    return minimize(lambda p: -logv(p, modele, g, ly0), depart,
                    method='L-BFGS-B', bounds=bornes)

def ecarts_types(p, modele, g, ly0, h=1e-4):
    """Écarts-types du MV : par la hessienne, puis robustes pour contrôle."""
    k = len(p)
    H = np.empty((k, k))
    for i in range(k):
        for j in range(k):
            ei, ej = np.zeros(k), np.zeros(k)
            ei[i], ej[j] = h, h
            H[i, j] = -(logv(p + ei + ej, modele, g, ly0)
                        - logv(p + ei - ej, modele, g, ly0)
                        - logv(p - ei + ej, modele, g, ly0)
                        + logv(p - ei - ej, modele, g, ly0))/(4*h*h)
    w = poids(p, modele)
    f = least_squares(lambda q: (g - croissance(q, modele, ly0))/w, p, bounds=BORNES[modele])
    J, e = f.jac, f.fun
    A = np.linalg.inv(J.T @ J)
    return np.sqrt(np.diag(np.linalg.inv(H))), np.sqrt(np.diag(A @ (J.T*e**2) @ J @ A))
Résultats
logs = {}
for nom, z in (('M0', np.log(n + 0.05)), ("M0'", np.log(c))):
    X = np.column_stack([np.ones(N), ly0, np.log(s), z])
    b, V, scr = mco(X, g)
    logs[nom] = -N/2*np.log(scr/N)
    print(nom, b.round(4), (b/np.sqrt(np.diag(V))).round(2), vitesse(b[1]),
          b[2]/(b[2] - b[1]), R @ b/np.sqrt(R @ V @ R), scr, logs[nom])

DEPARTS = {'M1': [[th, 8, 2, -2] for th in (0.05, 0.1, 0.3)],
           'M2': [[th, 7, al] for th in (0.05, 0.1, 0.3) for al in (0.4, 0.7)],
           'M3': [[7, al] for al in (0.3, 0.5, 0.7)]}
estimations = {}
for nom in ('M1', 'M2', 'M3'):
    depart, essais = mcnl(nom, g, ly0, DEPARTS[nom])
    ajustement = maxv(nom, g, ly0, depart.x)
    estimations[nom], logs[nom] = ajustement.x, -ajustement.fun
    classiques, robustes = ecarts_types(ajustement.x, nom, g, ly0)
    print(nom, depart.x.round(4), ajustement.x.round(4), classiques.round(4),
          robustes.round(4), logs[nom], sorted({round(2*e.cost, 6) for e in essais}))
Les MCNL, qui servent de point de départ, aboutissent au même minimum quel que soit le point de départ, et la maximisation de la vraisemblance part ensuite de leur solution. Le tableau suivant résume les estimations, avec les écarts-types tirés de la hessienne entre parenthèses ; les écarts-types robustes en diffèrent peu (0,042 au lieu de 0,049 pour le \(\alpha\) de M2), ce qui indique que la forme de variance donnée par le modèle n'est pas démentie par les données. Pour M0 et M0', la vitesse est commune à tous les pays, et \(\alpha\) est déduit des coefficients, \(\alpha = a_2/(a_2 - a_1)\) (voir l'exercice 1) ; pour M1, M2 et M3, la vitesse indiquée est la médiane des \(\beta_i\).
| Modèle | Vitesse (% par an) | \(\alpha\) | \(\theta\) | \(\ell\) |
|---|---|---|---|---|
| M0 | 1,43 | 0,581 | 480,22 | |
| M0' | 0,76 | 0,745 | 466,46 | |
| M1 | 0,77 | 0,094 (0,037) | 467,75 | |
| M2 | 0,84 | 0,710 (0,049) | 0,102 (0,037) | 467,40 |
| M3 | 2,85 | 0,653 (0,030) | \(1-\alpha\) | 460,28 |
def test_LR(contraint, libre):
    LR = 2*(logs[libre] - logs[contraint])
    return LR, 1 - stats.chi2.cdf(LR, 1)

print(test_LR('M2', 'M1'), test_LR('M3', 'M2'))
theta = {'M1': estimations['M1'][0], 'M2': estimations['M2'][0],
         'M3': 1 - estimations['M3'][1]}
for nom, th in theta.items():
    beta = th*c
    print(nom, np.median(beta), beta.min(), codes[beta.argmin()],
          beta.max(), codes[beta.argmax()], np.log(2)/np.median(beta))
Trois résultats se dégagent.
Remplacer le 0,05 commun par les taux propres à chaque pays dégrade l'ajustement. La log-vraisemblance passe de 480,2 (M0) à 466,5 (M0'), et le coefficient de \(\log(n_i + x + \delta_i)\) n'est plus significatif (sa statistique de Student vaut \(-0{,}76\)). La contrainte \(a_2 + a_3 = 0\) n'est plus rejetée (\(1{,}06\)), mais c'est surtout parce que ce régresseur n'explique plus grand-chose. Dans M0, \(\log(n_i + 0{,}05)\) ne varie qu'avec la croissance démographique, qui est négativement corrélée à la croissance du revenu par tête (le coefficient de corrélation vaut \(-0{,}38\)). Dans M0', ses variations viennent surtout de la dépréciation, qui est au contraire positivement corrélée à la croissance (\(0{,}22\)), si bien que \(\log(n_i + x + \delta_i)\) ne l'est presque plus (\(-0{,}06\)). Le modèle prédit pourtant qu'une dépréciation plus rapide abaisse le revenu de long terme, et donc la croissance. Le taux de dépréciation des PWT est une moyenne des taux propres à chaque type d'actif, pondérée par la composition du capital : il reflète la structure de l'investissement autant que l'usure du capital.
Des vitesses propres à chaque pays n'ajustent guère mieux qu'une vitesse commune. À régresseurs identiques, M1 et M0' ont le même nombre de paramètres et des log-vraisemblances voisines (467,75 contre 466,46). Les données distinguent mal les deux structures. L'intérêt des vitesses propres tient à la cohérence avec le modèle, et au test qu'elles permettent : dans M2, le paramètre \(\theta\) qui règle la vitesse est estimé indépendamment de \(\alpha\), et le modèle de Solow impose \(\theta = 1 - \alpha\). La contrainte de M2 sur les coefficients de la parenthèse n'est pas rejetée (rapport de vraisemblance de 0,71, probabilité critique de 0,40).
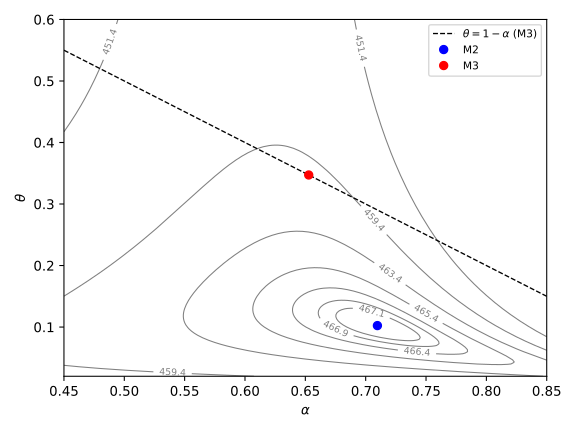
Le modèle de Solow complet est rejeté. La contrainte \(\theta = 1-\alpha\) fait perdre 7,1 points de log-vraisemblance, soit un rapport de vraisemblance de \(14{,}2\) et une probabilité critique de 0,00016. Sans la contrainte, la vitesse médiane est de 0,84 % par an, soit une demi-vie de 82 ans, et \(\alpha\) est estimé à 0,71. Avec la contrainte, la vitesse médiane est de 2,9 % par an (demi-vie de 24 ans), et va de 1,7 % en Grèce à 4,3 % aux Fidji. La figure suivante représente la log-vraisemblance de M2 en fonction de \(\alpha\) et \(\theta\) (la constante \(a\) est optimisée pour chaque couple). Le maximum est loin de la droite \(\theta = 1-\alpha\) : la valeur de \(\alpha\) qui rend compte des écarts de revenu entre pays implique une convergence bien trop rapide.
C'est, dans un autre cadre, le constat qui conduit Mankiw, Romer et Weil au modèle augmenté du capital humain : la vitesse de convergence y devient \(\beta_i = (1-\alpha-\lambda)(n_i+x+\delta_i)\), où \(\lambda\) est l'élasticité de la production au capital humain, et une part plus grande du capital au sens large ralentit la convergence.
Endogénéité
Toutes ces estimations supposent que la perturbation \(\varepsilon_i\) n'est corrélée ni avec les taux d'épargne et de croissance démographique, ni avec le revenu initial. Le cours pose explicitement la seconde hypothèse, \(\mathrm{Cov}(\varepsilon_i, \log y_j(0)) = 0\). Elle est pourtant difficile à défendre : puisque \(\log y_i(0) = a + \varepsilon_i + \log\hat y_i(0)\), un pays dont l'efficacité du travail est élevée a, toutes choses égales par ailleurs, un revenu initial élevé. Dans l'équation de croissance, le revenu initial est alors corrélé avec le terme d'erreur, qui contient \(\varepsilon_i\), et les estimateurs ne convergent plus vers les vraies valeurs des paramètres.
Pour mesurer l'effet de cette corrélation, simulons des données à partir du modèle M3, en retenant les valeurs estimées de \(\alpha\) et \(a\), les taux d'épargne, de croissance démographique et de dépréciation observés, et un écart-type de \(\varepsilon_i\) déduit des résidus. Les revenus de 2023 sont calculés avec la solution exacte de l'équation de Solow, et non avec son approximation log-linéaire : en notant \(z = \hat k^{1-\alpha}\), \(z(t) = z^{\star} + (z(0) - z^{\star})e^{-\beta_i t}\), où \(z^{\star} = s_i/(n_i+x+\delta_i)\) (voir la note sur la simulation du modèle de Solow). Nous considérons deux cas :
- dans le premier, le revenu initial est celui observé, et c'est la production initiale par tête efficace, \(\log\hat y_i(0)\), qui s'ajuste à \(\varepsilon_i\) : l'hypothèse du cours est vérifiée ;
- dans le second, \(\log\hat y_i(0)\) est fixé, et le revenu initial contient \(\varepsilon_i\).
Dans chaque cas, nous simulons 500 échantillons, estimons M2 et M3 par le maximum de vraisemblance, et testons \(\theta = 1-\alpha\) au seuil de 5 %.
a3, alpha3 = estimations['M3']
beta3 = (1 - alpha3)*c
epsilon = (g - croissance(estimations['M3'], 'M3', ly0))/poids(estimations['M3'], 'M3')
sigma = epsilon.std()
rng = np.random.default_rng(2014)

def simulation(endogene):
    """Taux de croissance simulés avec la solution exacte, et revenus initiaux."""
    e = rng.normal(0, sigma, N)
    if endogene:
        lyh0 = ly0 - a3
        ly0_sim = lyh0 + a3 + e
    else:
        ly0_sim = ly0
        lyh0 = ly0 - a3 - e
    z0 = np.exp(lyh0*(1 - alpha3)/alpha3)
    z = s/c + (z0 - s/c)*np.exp(-beta3*t)
    lyt = a3 + e + x*t + alpha3/(1 - alpha3)*np.log(z)
    return (lyt - ly0_sim)/t, ly0_sim

simulations = {}
for endogene in (False, True):
    theta2, alpha3_sim, rejets = [], [], 0
    for r in range(500):
        g_sim, ly0_sim = simulation(endogene)
        m2 = maxv('M2', g_sim, ly0_sim, [0.1, 7, 0.6])
        m3 = maxv('M3', g_sim, ly0_sim, [7, 0.6])
        LR = 2*(m3.fun - m2.fun)
        rejets += LR > stats.chi2.ppf(0.95, 1)
        theta2.append(m2.x[0])
        alpha3_sim.append(m3.x[1])
    simulations[endogene] = np.array(theta2)
    print(endogene, np.mean(alpha3_sim), np.median(theta2), rejets/500)
print(sigma, 1 - alpha3, simulations[False].min(), np.percentile(simulations[False], 5),
      simulations[True].max(), np.percentile(simulations[True], 95))
Dans le premier cas, l'estimateur de \(\alpha\) dans M3 est presque sans biais (0,655 en moyenne pour une vraie valeur de 0,653) : l'approximation log-linéaire n'est pas en cause. Le test rejette la contrainte \(\theta = 1-\alpha\) dans 8 % des échantillons, un peu plus que les 5 % annoncés : avec 110 pays, l'approximation de la loi du rapport de vraisemblance par un \(\chi^2\) reste grossière. Dans le second cas, l'estimation de \(\alpha\) monte à 0,74, la médiane de \(\hat\theta\) tombe à 0,06 alors que la vraie valeur est de 0,35, et le test rejette la contrainte dans tous les échantillons. La figure suivante compare les deux distributions de \(\hat\theta\) à l'estimation obtenue sur les données.
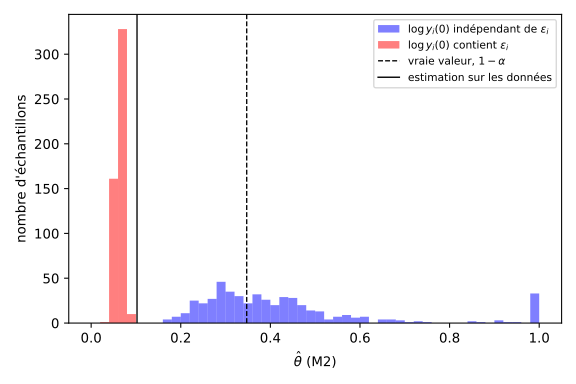
L'estimation obtenue sur les données, 0,102, est inférieure à toutes les estimations du premier cas, dont la plus petite vaut 0,17, et supérieure à toutes celles du second, dont la plus grande vaut 0,09. Elle pourrait provenir d'un modèle de Solow dans lequel le revenu initial ne contient qu'une partie de \(\varepsilon_i\) : le rejet du modèle complet viendrait alors de cette corrélation, et non d'un défaut du modèle. Elle pourrait aussi provenir d'un modèle où la vitesse de convergence n'est pas celle du modèle de Solow : en coupe transversale, on ne peut pas trancher. On ne peut pas non plus instrumenter le revenu initial par des revenus plus anciens, qui contiennent la même composante permanente \(\varepsilon_i\). La seconde source d'endogénéité, la corrélation de \(\varepsilon_i\) avec les taux d'épargne et de croissance démographique, que Mankiw, Romer et Weil excluent par hypothèse, pose le même problème.
La réponse habituelle consiste à suivre les pays sur plusieurs périodes. En découpant 1960-2023 en périodes de longueur \(\tau\), l'équation de croissance s'écrit
\begin{equation*} \log y_{i,k+1} = \rho_i\log y_{i,k} + (1-\rho_i)\frac{\alpha}{1-\alpha}\bigl(\log s_{i,k} - \log(n_i+x+\delta_i)\bigr) + \mu_i + \gamma_{i,k} + v_{i,k+1} \end{equation*}avec \(\rho_i = e^{-\beta_i\tau}\), un effet pays \(\mu_i = (1-\rho_i)\log A_i(0)\), qui absorbe \(\varepsilon_i\), et un terme de tendance \(\gamma_{i,k}\) connu à \(\alpha\) près. Cet effet fixe peut être éliminé en différenciant l'équation, et les revenus des périodes antérieures deviennent alors des instruments valides. La littérature montre toutefois que le résultat dépend beaucoup de la méthode. Avec des effets fixes, Islam (1995) trouve des vitesses de 4 à 5 % par an sur les grands échantillons, et de plus de 9 % pour les pays de l'OCDE. Avec la méthode des moments généralisés (GMM) appliquée à l'équation en différences, Caselli, Esquivel et Lefort (1996) trouvent environ 10 %. Bond, Hoeffler et Temple (2001) montrent que les instruments sont alors faibles, et trouvent 2 à 4 % avec la méthode dite des GMM en système. Les simulations de Hauk et Wacziarg (2009) indiquent que les effets fixes et les GMM en différences surestiment fortement la vitesse de convergence, et que l'estimateur en coupe transversale, celui de cette note, est le moins biaisé en présence d'erreurs de mesure. Enfin, lorsque chaque pays a sa propre vitesse, sans lien avec le modèle, Lee, Pesaran et Smith (1997) trouvent des vitesses moyennes de l'ordre de 30 % par an, très imprécises. La structure \(\beta_i = (1-\alpha)(n_i+x+\delta_i)\) se situe entre ces deux extrêmes : elle autorise des vitesses différentes, mais les relie à un seul paramètre. Son estimation en panel fait l'objet de la note suivante.
Conclusion
Prendre au sérieux la vitesse de convergence du modèle de Solow ne demande qu'un changement d'estimateur : une part du capital commune suffit à donner à chaque pays sa propre vitesse, et le modèle dit aussi comment pondérer les pays, ce dont le maximum de vraisemblance tire parti. Sur les données des PWT, ces vitesses propres n'ajustent guère mieux qu'une vitesse commune, et le modèle de Solow complet est rejeté, parce que la part du capital qui rend compte des écarts de revenu implique une convergence trop rapide. Ce verdict est cependant fragile : la même estimation, appliquée à des données simulées par un modèle de Solow exact, conduit au même rejet dès que le revenu initial contient l'efficacité du travail. Seule une estimation en panel permet de séparer les deux explications.
Exercices
On suppose la vitesse de convergence commune à tous les pays. Exprimez les coefficients \(a_1\) et \(a_2\) de la régression de Mankiw, Romer et Weil en fonction de \(\alpha\), \(\beta\) et \(t\), et montrez que \(\alpha = a_2/(a_2 - a_1)\). Calculez la valeur de \(\alpha\) impliquée par les estimations de M0 et de M0', et comparez-la à celle de M2.
Corrigé
Dans l'équation de croissance, le revenu initial est multiplié par \(a_1 = -(1-e^{-\beta t})/t\) et le logarithme du taux d'épargne par \(a_2 = \frac{1-e^{-\beta t}}{t}\frac{\alpha}{1-\alpha} = -a_1\frac{\alpha}{1-\alpha}\). On en déduit \(\alpha/(1-\alpha) = -a_2/a_1\), soit \(\alpha = a_2/(a_2 - a_1)\). Les estimations de M0 donnent \(\hat a_1 = -0{,}0094\) et \(\hat a_2 = 0{,}0131\), d'où \(\alpha = 0{,}58\) ; celles de M0', \(\hat a_1 = -0{,}0061\) et \(\hat a_2 = 0{,}0177\), d'où \(\alpha = 0{,}75\). La valeur de M2, 0,71, se situe entre les deux. Dans les trois cas, la part du capital est bien supérieure à la valeur de \(1/3\) que l'on retient d'ordinaire. Et même avec ces valeurs élevées, la vitesse de convergence qu'implique le modèle, \((1-\alpha)(n_i+x+\delta_i)\), dépasse dans tous les pays la vitesse estimée.
Calculez la demi-vie de l'écart à l'état stationnaire, \(\log 2/\beta_i\), pour le pays qui converge le plus lentement et pour celui qui converge le plus vite, avec les estimations de M2 et de M3.
Corrigé
for nom in ('M2', 'M3'):
    beta = theta[nom]*c
    print(nom, codes[beta.argmin()], np.log(2)/beta.min(),
          codes[beta.argmax()], np.log(2)/beta.max())
La vitesse est la plus faible en Grèce, où la population croît lentement et où le capital se déprécie lentement, et la plus forte aux Fidji, où la dépréciation est la plus rapide de l'échantillon. Avec M2, la demi-vie va de 55 ans aux Fidji à 137 ans en Grèce ; avec M3, de 16 à 40 ans. Les vitesses propres à chaque pays ne sont pas un détail : d'un pays à l'autre, la demi-vie varie du simple au plus que double.
Programmez l'algorithme de Gauss-Newton pour estimer M3, en calculant la
jacobienne par différences finies, et vérifiez qu'il converge vers
l'estimation obtenue avec least_squares.
Corrigé
def gauss_newton(p, iterations=8, h=1e-6):
    for k in range(iterations):
        e = g - croissance(p, 'M3', ly0)
        J = np.column_stack([(croissance(p + h*u, 'M3', ly0)
                              - croissance(p - h*u, 'M3', ly0))/(2*h)
                             for u in np.eye(len(p))])
        p = p + np.linalg.solve(J.T @ J, J.T @ e)
        print(k, p.round(6), e @ e)
    return p

gauss_newton(np.array([7.0, 0.5]))
print(estimations['M3'].round(6))
Partant de \(a = 7\) et \(\alpha = 0{,}5\), l'algorithme atteint en quelques
itérations l'estimation de least_squares, \(\hat a = 6{,}570\) et
\(\hat\alpha = 0{,}645\), et la somme des carrés des résidus ne diminue plus.
Chaque itération est une régression par les MCO des résidus sur les colonnes
de la jacobienne. C'est de ce point que part la maximisation de la
vraisemblance, qui déplace ensuite l'estimation à \(\hat\alpha = 0{,}653\).
On note \(w_i(\theta) = (1-e^{-\beta_i t})/t\), de sorte que \(\bar g_{y,i} - f_i(\theta) = w_i(\theta)\varepsilon_i\). Un collègue propose d'estimer \(\theta\) en minimisant \(\sum_i\bigl((\bar g_{y,i} - f_i(\theta))/w_i(\theta)\bigr)^2\), pour se débarrasser de l'hétéroscédasticité. Pourquoi cet estimateur tend-il à surestimer la vitesse de convergence ?
Corrigé
Les poids \(1/w_i(\theta)\) dépendent des paramètres. Or \(w_i\) croît avec la vitesse de convergence : pour des résidus donnés, augmenter la vitesse réduit le critère, simplement parce qu'on divise par un nombre plus grand. L'estimateur est donc attiré vers les vitesses élevées, indépendamment de l'ajustement. C'est exactement ce que le terme \(-\sum_i\log w_i(\theta)\) de la log-vraisemblance empêche. C'est ce que l'on observe sur nos données :
def mcnl_divise(modele, p0):
    def residus(p):
        th = p[0] if modele == 'M2' else 1 - p[1]
        return (g - croissance(p, modele, ly0))*t/(1 - np.exp(-th*c*t))
    return least_squares(residus, p0, bounds=BORNES[modele]).x

p2, p3 = mcnl_divise('M2', [0.1, 7, 0.6]), mcnl_divise('M3', [7, 0.6])
print(p2, np.median(p2[0]*c), p3, np.median((1 - p3[1])*c))
Avec M3, la vitesse médiane passe de 2,9 % à 3,7 % par an. Avec M2, où la vitesse ne dépend pas de \(\alpha\), \(\theta\) atteint la borne supérieure imposée à l'optimisation, \(\theta = 3\), soit une vitesse médiane de 25 % par an. Lorsque la variance d'une erreur dépend des paramètres, pondérer sans rien ajouter d'autre ne suffit donc pas. On peut soit fixer les poids, en les calculant à partir d'une première estimation puis en les gardant constants, soit maximiser la vraisemblance, qui pénalise les vitesses élevées par le terme \(-\sum_i\log w_i(\theta)\). Sur nos données, les deux solutions donnent des estimations voisines.
Références
La régression de convergence conditionnelle est due à Mankiw, N. G., Romer, D. et Weil, D. (1992), « A Contribution to the Empirics of Economic Growth », Quarterly Journal of Economics, 107(2), 407-437. Les estimations en panel citées sont celles de Islam, N. (1995), « Growth Empirics: A Panel Data Approach », Quarterly Journal of Economics, 110(4), 1127-1170, de Caselli, F., Esquivel, G. et Lefort, F. (1996), « Reopening the Convergence Debate: A New Look at Cross-Country Growth Empirics », Journal of Economic Growth, 1(3), 363-389, de Bond, S., Hoeffler, A. et Temple, J. (2001), « GMM Estimation of Empirical Growth Models », CEPR Discussion Paper 3048, et de Lee, K., Pesaran, M. H. et Smith, R. (1997), « Growth and Convergence in a Multi-Country Empirical Stochastic Solow Model », Journal of Applied Econometrics, 12(4), 357-392. Les simulations sont celles de Hauk, W. et Wacziarg, R. (2009), « A Monte Carlo Study of Growth Regressions », Journal of Economic Growth, 14(2), 103-147. Pour une vue d'ensemble, voir Durlauf, S., Johnson, P. et Temple, J. (2005), « Growth Econometrics », dans Aghion, P. et Durlauf, S. (dir.), Handbook of Economic Growth, vol. 1A, chapitre 8, 555-677.
Les données proviennent de la version 11.0 des Penn World Tables (Groningen Growth and Development Centre, 2025, doi:10.34894/FABVLR), décrites dans Feenstra, R., Inklaar, R. et Timmer, M. (2015), « The Next Generation of the Penn World Table », American Economic Review, 105(10), 3150-3182. Sur le modèle de Solow lui-même, on se reportera aux notes sur le modèle de Solow et sur sa simulation.